Практические разборы: что устроено внутри, какой шаг повторить и где авторский опыт заканчивается.
🗓 окно 2026-10-05 — 2026-10-12⚡ статей 9👀 на радаре 4📡 отсканировано 326
О чём пишут на этой неделе
В этой подборке много работ о том, как давать агенту контекст и проверять его действия. Рецепты с командами соседствуют с методами оценки: плацебо для скиллов, A/B для ревьюера, повторяемые прогоны поиска. Отдельная тема — точность там, где ответ опирается на данные: артикулы в RAG, адреса в MCP и события Wazuh. В каждой карточке указан шаг, который можно проверить на своей системе.
⚡
Главные статьи недели
01
Локальный vLLM на Windows: проверяйте стек по слоям
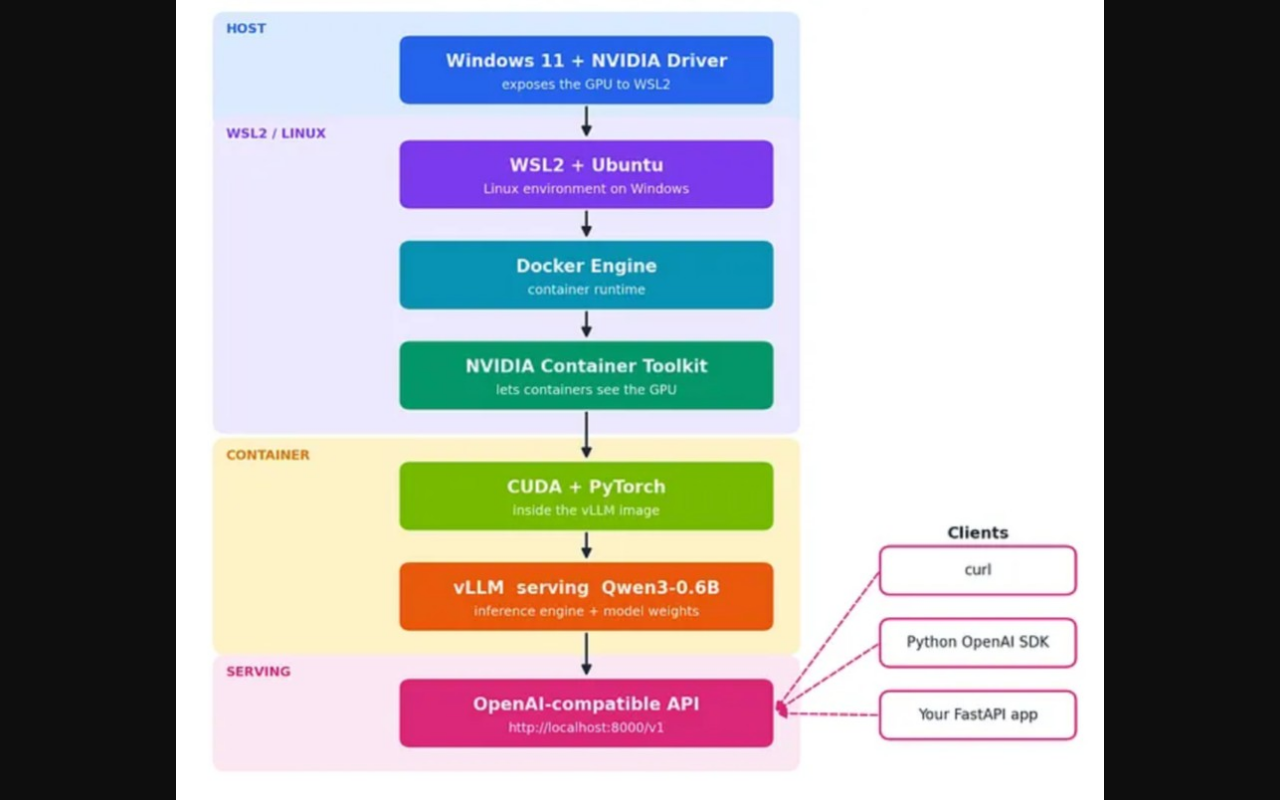
Автор поднимает Qwen3-0.6B через WSL2, Docker и vLLM. Инструкция полезна, когда модель должна отвечать через локальный OpenAI-совместимый API, а сбой нужно найти на конкретном слое.
🔑 Главное
Сначала проверяются драйвер и nvidia-smi в WSL2, затем доступ к GPU внутри контейнера.
Контейнер vLLM запускается с --gpu-memory-utilization 0.80 и --max-model-len 2048; модель — Qwen3-0.6B.
Автор проверяет /health и /v1/models. Пример JSON для chat completion в тексте требует исправления перед запуском.
⚡ Попробовать за вечер
В Windows с NVIDIA GPU проверьте nvidia-smi в Ubuntu WSL2 и CUDA-контейнере.
Запустите приведённый контейнер vLLM с Qwen3-0.6B и ограничением контекста 2048.
Метрика: оба адреса, /health и /v1/models, отвечают; запишите время старта и расход видеопамяти.
Ограничение: Автор запускал стек на GPU с 4 ГБ VRAM. Образ latest не закреплён, а JSON-пример chat completion в сохранённом тексте испорчен.
из статьи⌕
На картинке: Схема показывает цепочку Windows → WSL2 → Docker → vLLM → локальный API.
Автор сравнивает способы показывать агенту дерево и фрагменты кода через DevProjex. Полезен сам метод: ограничить объём, повторить задачи и смотреть, какие файлы агент пропустил.
🔑 Главное
В статье сравниваются лимиты тела объявления: без ограничения, 1 800 и 3 000 символов.
Замеры сделаны на 36 сессиях: один бинарник, четыре задачи, по три повтора на лимит.
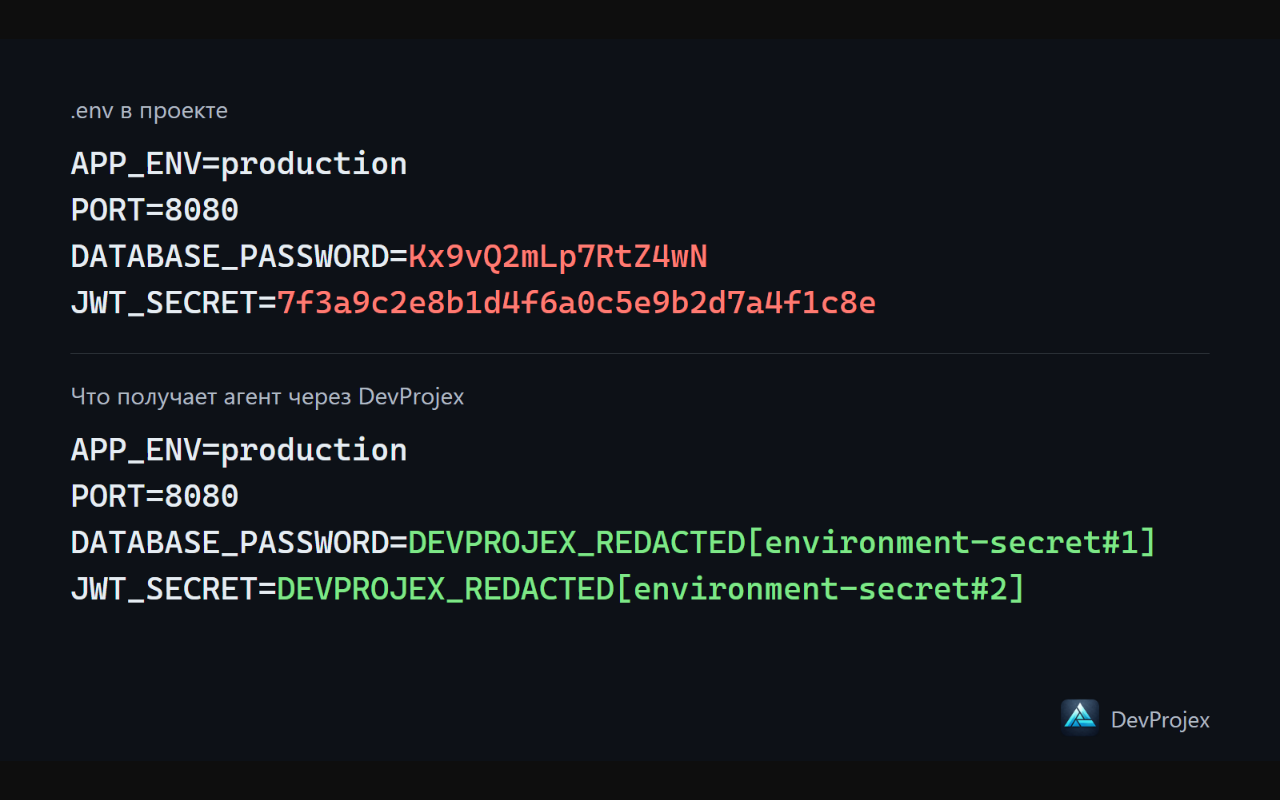
Маскирование на MCP-сервере не запрещает агенту открыть .env обычным инструментом чтения.
⚡ Попробовать за вечер
Возьмите четыре одинаковые задачи на своём репозитории и зафиксируйте бинарник агента.
Сравните три лимита выдачи фрагментов; повторите каждый сценарий трижды.
Метрика: стоимость и число ходов рядом с полнотой ответа и списком пропущенных обязательных файлов.
Ограничение: Это авторский бенчмарк, а не независимая проверка. Цифры выигрыша и защита секретов на другие проекты не переносятся.
из статьи⌕
На картинке: Пример показывает, как сервер заменяет значения секретов перед выдачей агенту.
QA-ошибку агента превращайте в проверяемое правило
✍ КонстантинХабр⏱ ≈9 минБлог компании Банки.руТестирование IT-систем
О чём
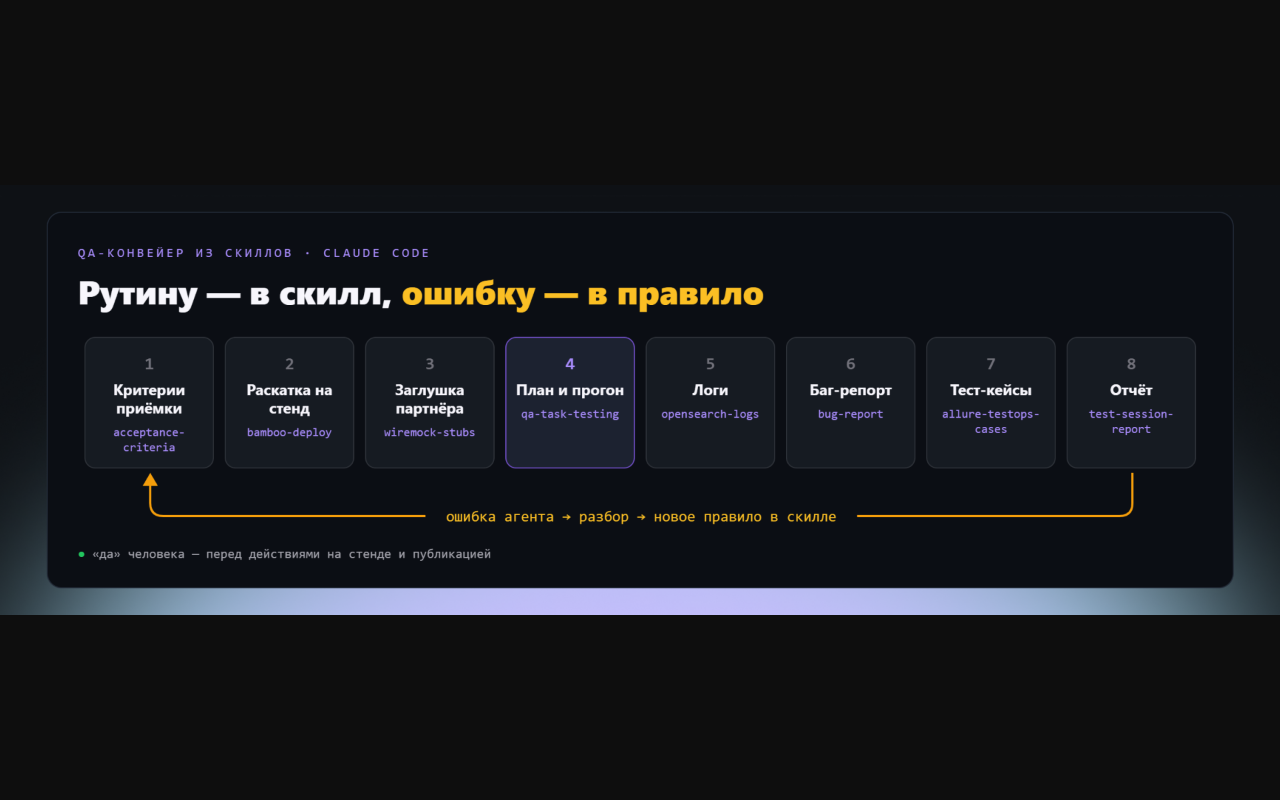
QA-инженер описывает набор скиллов для Claude Code и цикл: найти неверный вывод, восстановить недостающую проверку, записать короткое правило. Начать можно с одного скилла для баг-репорта.
🔑 Главное
bug-report ставится отдельно командой npx skills add.
Перед выводом BUG автор заставляет агента сверить факт с требованием и сформулировать расхождение.
Полный многоагентный конвейер зависит от Jira, Confluence и других сервисов; публичную версию автор целиком не проверял.
⚡ Попробовать за вечер
Установите bug-report из репозитория автора.
Дайте агенту старый дефект с ответом API и требованием; проверьте, где он ошибся.
Метрика: в отчёте есть факт, требование и расхождение, каждое подтверждено источником.
Ограничение: Скиллы нужно подстраивать под свой стек; экспериментальный автопилот нельзя считать готовым рецептом.
из статьи⌕
На картинке: Схема показывает этапы QA-сценария и возврат ошибки агента в правило.
RAG по артикулам: соединить точный и семантический поиск
✍ Дмитрий ПименовХабр⏱ ≈6 минМашинное обучениеNatural Language Processing
О чём
В базе из 11 000 технических файлов похожие номера моделей мешали поиску по эмбеддингам. Автор показывает схему dense+sparse поиска в Qdrant, фильтры по модели и категории, затем реранкер.
🔑 Главное
BAAI/bge-m3 даёт плотный и разреженный векторы; Qdrant сливает результаты через RRF.
Поиск с фильтрами идёт рядом с поиском без них: ошибка извлечения модели не обнуляет все кандидаты.
После дедупликации реранкер bge-reranker-v2-m3 выбирает 20 фрагментов. Прирост качества не измерен.
⚡ Попробовать за вечер
На тестовом наборе документов сохраните артикул и категорию отдельными полями.
Сравните выдачу dense, sparse и RRF для одинаковых запросов, затем добавьте реранкер.
Метрика: доля запросов, где нужный паспорт попал в первые 20, с ручной сверкой цифр по файлу.
Ограничение: В статье есть фрагмент Qdrant-запроса, но нет полного кода индексации и запуска реранкера.
Пробел в пути импорта CLAUDE.md проверяется контрольными словами
✍ Сергей БурыйХабр⏱ ≈4 минИскусственный интеллектПрограммирование
О чём
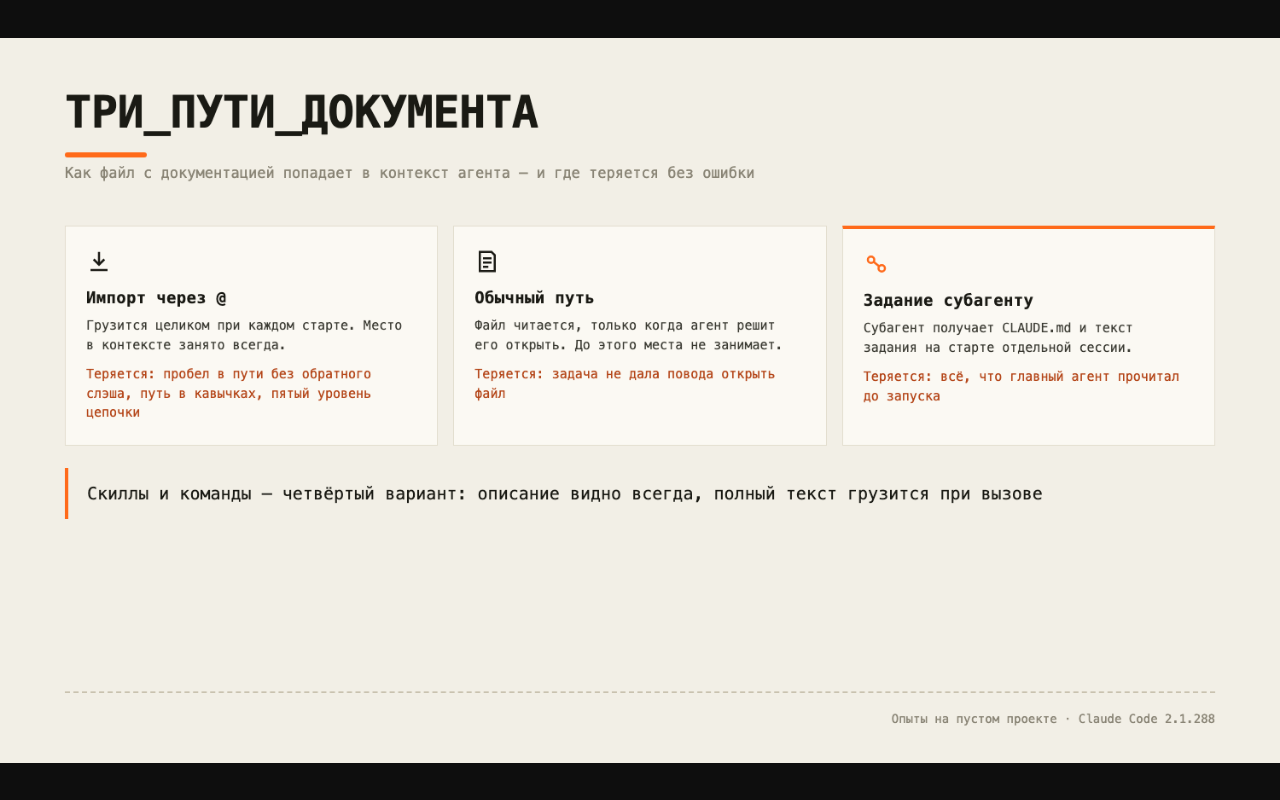
Автор показывает минимальный опыт для Claude Code: файлы с кодовыми словами, импорт через @ и запрет обычного чтения. Так видно, попал ли документ в стартовый контекст.
🔑 Главное
Путь @Design Docs/a.md в опыте не загрузился; вариант с экранированным пробелом загрузился.
Команда claude -p с --disallowedTools "Read,Bash,Grep,Glob" не даёт агенту открыть файл позже.
Наблюдение относится к Claude Code 2.1.288 и режиму -p; в другой версии его нужно повторить.
⚡ Попробовать за вечер
В пустом репозитории создайте два файла с разными контрольными словами в папке Design Docs.
Добавьте оба варианта импорта в CLAUDE.md и запустите опыт автора с запретом файловых инструментов.
Метрика: агент назвал слово только из ожидаемого импорта; проверьте также /context.
Ограничение: Автор проверял версию 2.1.288 в режиме claude -p; в диалоге поведение может отличаться.
из статьи⌕
На картинке: Схема показывает три способа загрузки документа и места, где он может потеряться.
Автор проверил девять скиллов в трёх группах: без скилла, с нейтральным текстом похожей длины и с настоящим скиллом. Команду для повторного запуска одного из опытов он даёт в статье.
🔑 Главное
Каждый запуск идёт в чистом Docker-контейнере через Harbor.
Плацебо отделяет пользу инструкции от цены самого текста в контексте.
Опыт охватывает одну модель и короткие задачи; результаты для своих скиллов нужно измерять отдельно.
⚡ Попробовать за вечер
Запустите uvx skill-placebo run DietrichGebert/ponytail для одного опубликованного сценария.
Откройте METHOD.md и логи; сравните условия без скилла, с плацебо и со скиллом.
Метрика: успешность и стоимость каждого условия на одинаковых задачах, с повторениями.
Ограничение: В статье не описано добавление произвольного скилла в стенд; результаты нельзя переносить на длинные сессии.
MCP-геопоиск: порядок шагов и типы аргументов важнее промпта
✍ Юлия ТарасоваХабр⏱ ≈16 минБлог компании 2ГИСИскусственный интеллект
О чём
Команда 2ГИС разбирает MCP-сервер с геокодированием, поиском мест и построением маршрута. Статья полезна как схема контракта для агента, который работает с адресами.
🔑 Главное
radius_m ограничен диапазоном 1–2 000, транспорт берётся из закрытого списка.
Сначала нужно геокодировать адрес и проверить город и тип кандидата, затем искать вокруг явной точки.
Валидация формы не определяет, выдумана ли координата; полного кода сервера нет.
⚡ Попробовать за вечер
Опишите geocode_address, search_places и build_route как отдельные типизированные инструменты.
Проверьте запрет сортировки по расстоянию без исходной точки и неверный город в ответе геокодера.
Метрика: тесты отклоняют плохие аргументы и сохраняют ссылку на исходный геокодированный адрес.
Ограничение: Это переносимый метод, а не готовый сервер; работа через 2ГИС требует его API.
LLM-поиск по событиям Wazuh: версии плагинов и проверка запросов
✍ Андрей ЕфремовХабр⏱ ≈28 минБлог компании SelectelИнформационная безопасность
О чём
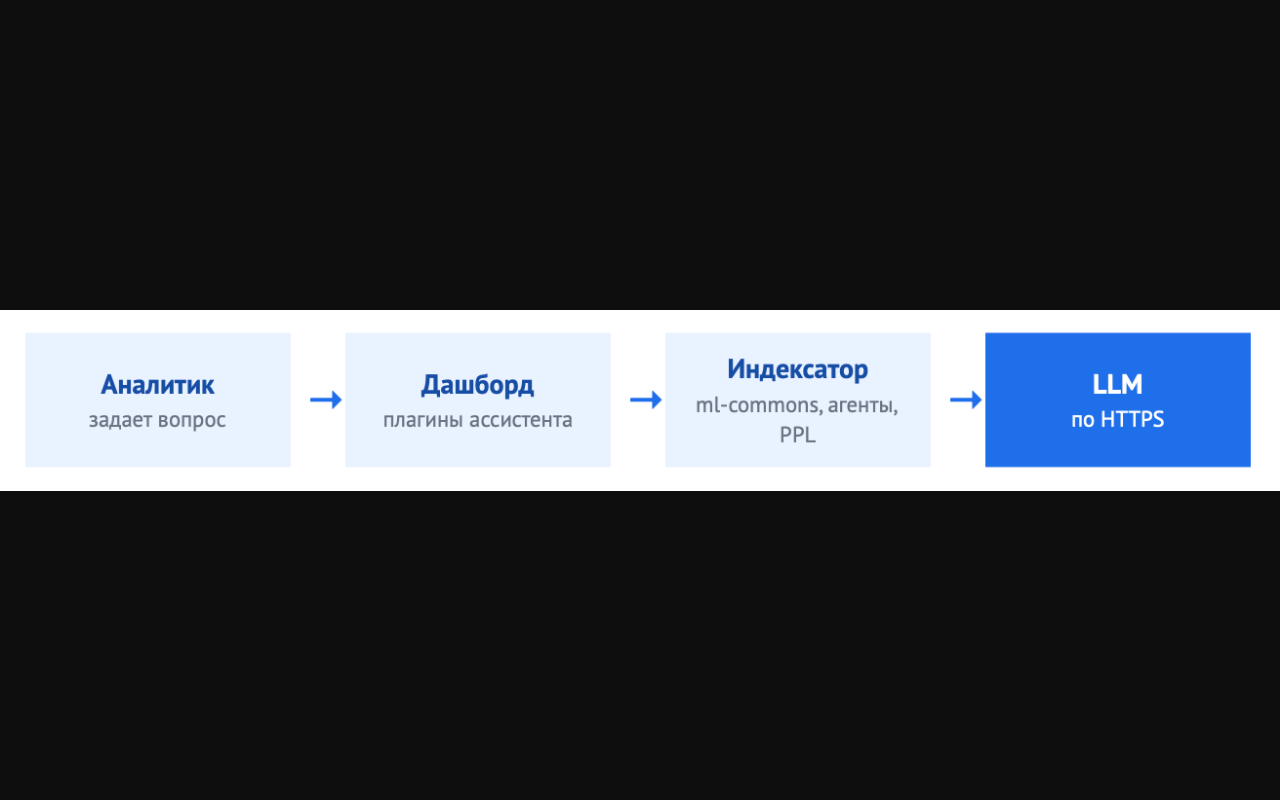
Авторы подключают OpenSearch Assistant к Wazuh 4.14.7, а затем LLM к данным безопасности. Статья даёт команды установки, проверку версии и настройку коннектора.
🔑 Главное
Для Wazuh 4.14.7 нужен OpenSearch 2.19.5; версии плагинов должны совпадать.
После регистрации коннектора и PPL-агента выполненный запрос виден пользователю.
Чат может выбрать неверное поле или лишний фильтр; итоговые числа надо сверять обычным поиском.
⚡ Попробовать за вечер
На тестовом Wazuh выполните GET / и проверьте version.number до установки плагинов.
Пройдите команды статьи для ml-commons-коннектора и PPL-агента.
Метрика: простой вопрос даёт проверяемый PPL-запрос, а его число совпадает с обычным поиском в Discover.
Ограничение: Проверено под admin; права других ролей не настроены. Кнопка Explain Document требует пересборки интерфейсного плагина.
из статьи⌕
На картинке: Схема показывает маршрут вопроса аналитика через Dashboard и индексатор к LLM.
AI-ревью кода: проверять замечание и закреплять PR за группой
✍ Виктор ПлошихинХабр⏱ ≈8 минБлог компании ЯндексБлог компании Yandex Cloud & Yandex Infrastructure
О чём
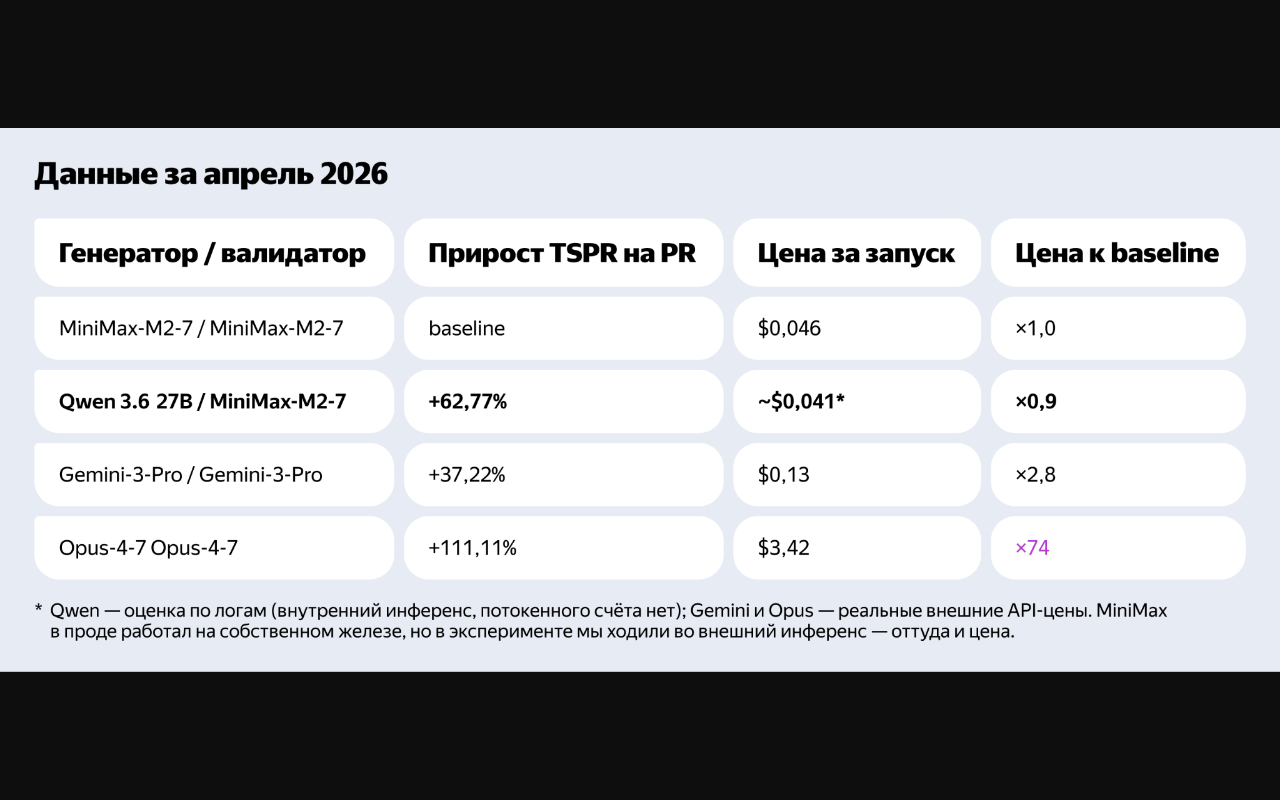
Команда описывает внутренний NeuroReview: одна модель предлагает замечания, другая их проверяет. Переносимый вывод здесь в методе оценки, а не в готовом сервисе.
🔑 Главное
До публикации сервис сверяет файл, строку и фрагмент замечания с репозиторием.
В A/B-тесте PR и все последующие итерации остаются в одной группе.
TSPR отражает реакцию разработчика на замечание; это прокси, а не измерение сэкономленного времени.
⚡ Попробовать за вечер
В существующем ревью-пайплайне добавьте проверку пути, строки и фрагмента перед отправкой замечания.
Распределяйте PR между двумя конфигурациями детерминированно; сохраняйте группу для следующих правок.
Метрика: принятые и отклонённые замечания на PR, задержка ответа и цена запуска.
Ограничение: NeuroReview работает на внутренней платформе Comrade. Код, промпты и веса метрики в статье не опубликованы.
из статьи⌕
На картинке: Таблица показывает авторское сравнение конфигураций ревьюера, TSPR и цены.
 из статьи⌕